深層学習とは?AI・機械学習との決定打と仕組みの全貌【2026年最新版】
生成AIの急速な普及や自動運転の実用化が進む中、テクノロジーの最前線で中核を担っているのが「深層学習(ディープラーニング)」です。しかし、ビジネスの現場やニュース記事で頻出する一方で、「人工知能(AI)や従来の機械学習と一体何が違うのか」「どのような仕組みでコンピュータが自律的に賢くなっているのか」を明確に整理できている人は多くありません。
2006年にジェフリー・ヒントン氏らによってブレイクスルーがもたらされて以来、深層学習は単なる学術研究の枠を完全に飛び越えました。現在では画像認識、自然言語処理、創薬、ロボティクスに至るまで産業構造そのものを塗り替えています。2026年現在の最新状況を踏まえ、その基本概念から内部構造、産業界における活用実態、さらには導入現場が直面する盲点まで、取材データと専門的知見を交えて徹底的に解剖します。
📌 【この記事の重要ポイントまとめ】
- 要点1:深層学習は「AI」という広大な概念の中に含まれる「機械学習」の発展系であり、人間が特徴を教えなくてもデータの本質を自力で抽出する自己学習技術である。
- 要点2:脳の神経回路を模したニューラルネットワークを多層化(ディープ化)することで、画像認識の精度向上やChatGPTに代表される自然言語処理の飛躍的進化を実現した。
- 要点3:莫大な計算リソースとブラックボックス化という課題を抱えつつも、2026年現在は軽量化技術やエッジAIとの融合によって実務導入の敷居が大きく下がりつつある。
【根本解剖】深層学習(ディープラーニング)とは何か?AI・機械学習との決定的な違い
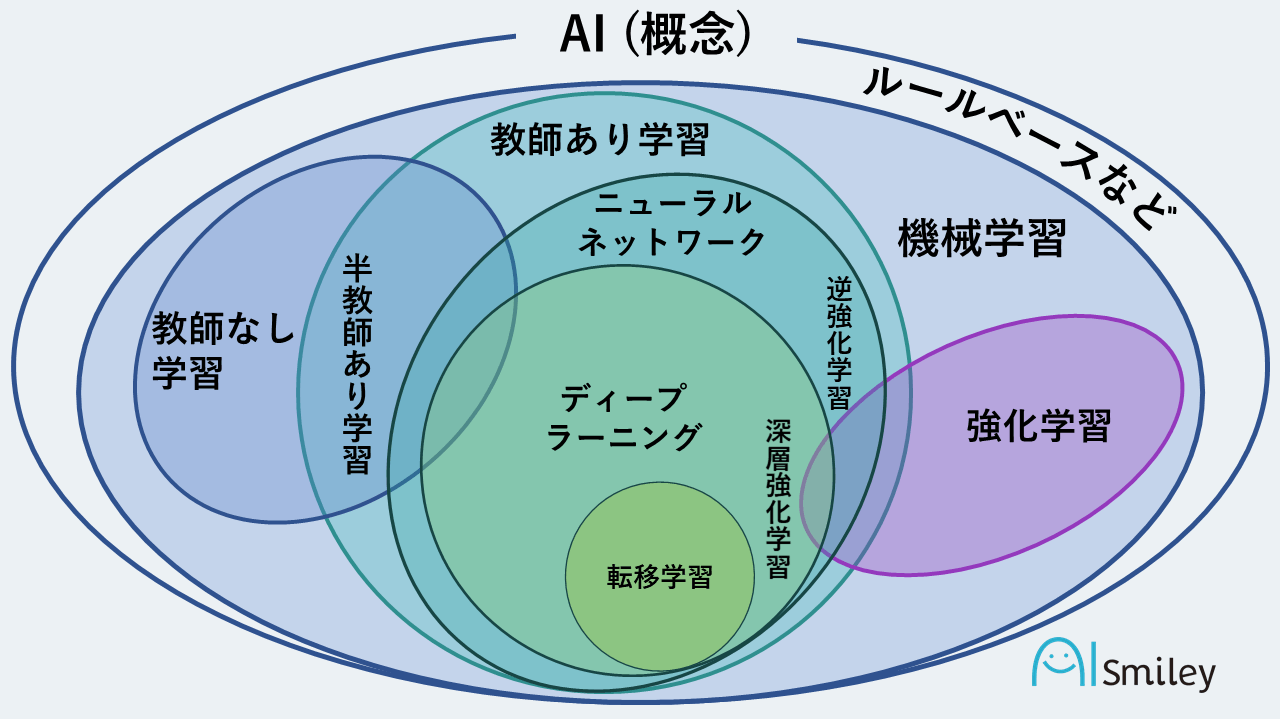
テクノロジー用語として混同されがちな「人工知能(AI)」「機械学習」「深層学習(ディープラーニング)」ですが、これらは対立する概念ではなく、明確な同心円の包含関係にあります。もっとも外側に位置するのが「人工知能(AI)」という広範な学問・概念であり、その中にコンピュータが自ら規則性を学ぶ手法としての「機械学習」が存在し、さらにその中心部で高度な処理を担う特化技術が「深層学習」です。
専門家や業界団体の公式資料でも定義されている通り、深層学習 機械学習 違いを分ける最大の境界線は「特徴量(データの特徴を数値化したもの)の指定を人間が行うか、コンピュータが自律的に発見するか」に集約されます。
従来の機械学習(サポートベクターマシンやランダムフォレストなど)では、人間が「猫の画像なら耳の尖り具合やヒゲの有無を見るべきだ」とあらかじめ特徴を設計し、入力データとして整える必要がありました。これに対して深層学習は、大量の生データ(ピクセル情報や音声波形など)をそのまま流し込むだけで、コンピュータ自らが「何が識別に必要な特徴なのか」を階層的に抽出します。人工知能 AI 違いを語る際、ルールベースの自動化システムと、深層学習を用いた自己進化型システムとの間には、認知能力の次元において超えられない壁が存在します。

ディープラーニングを支える「ニューラルネットワーク」の仕組みと主要アルゴリズムの種類
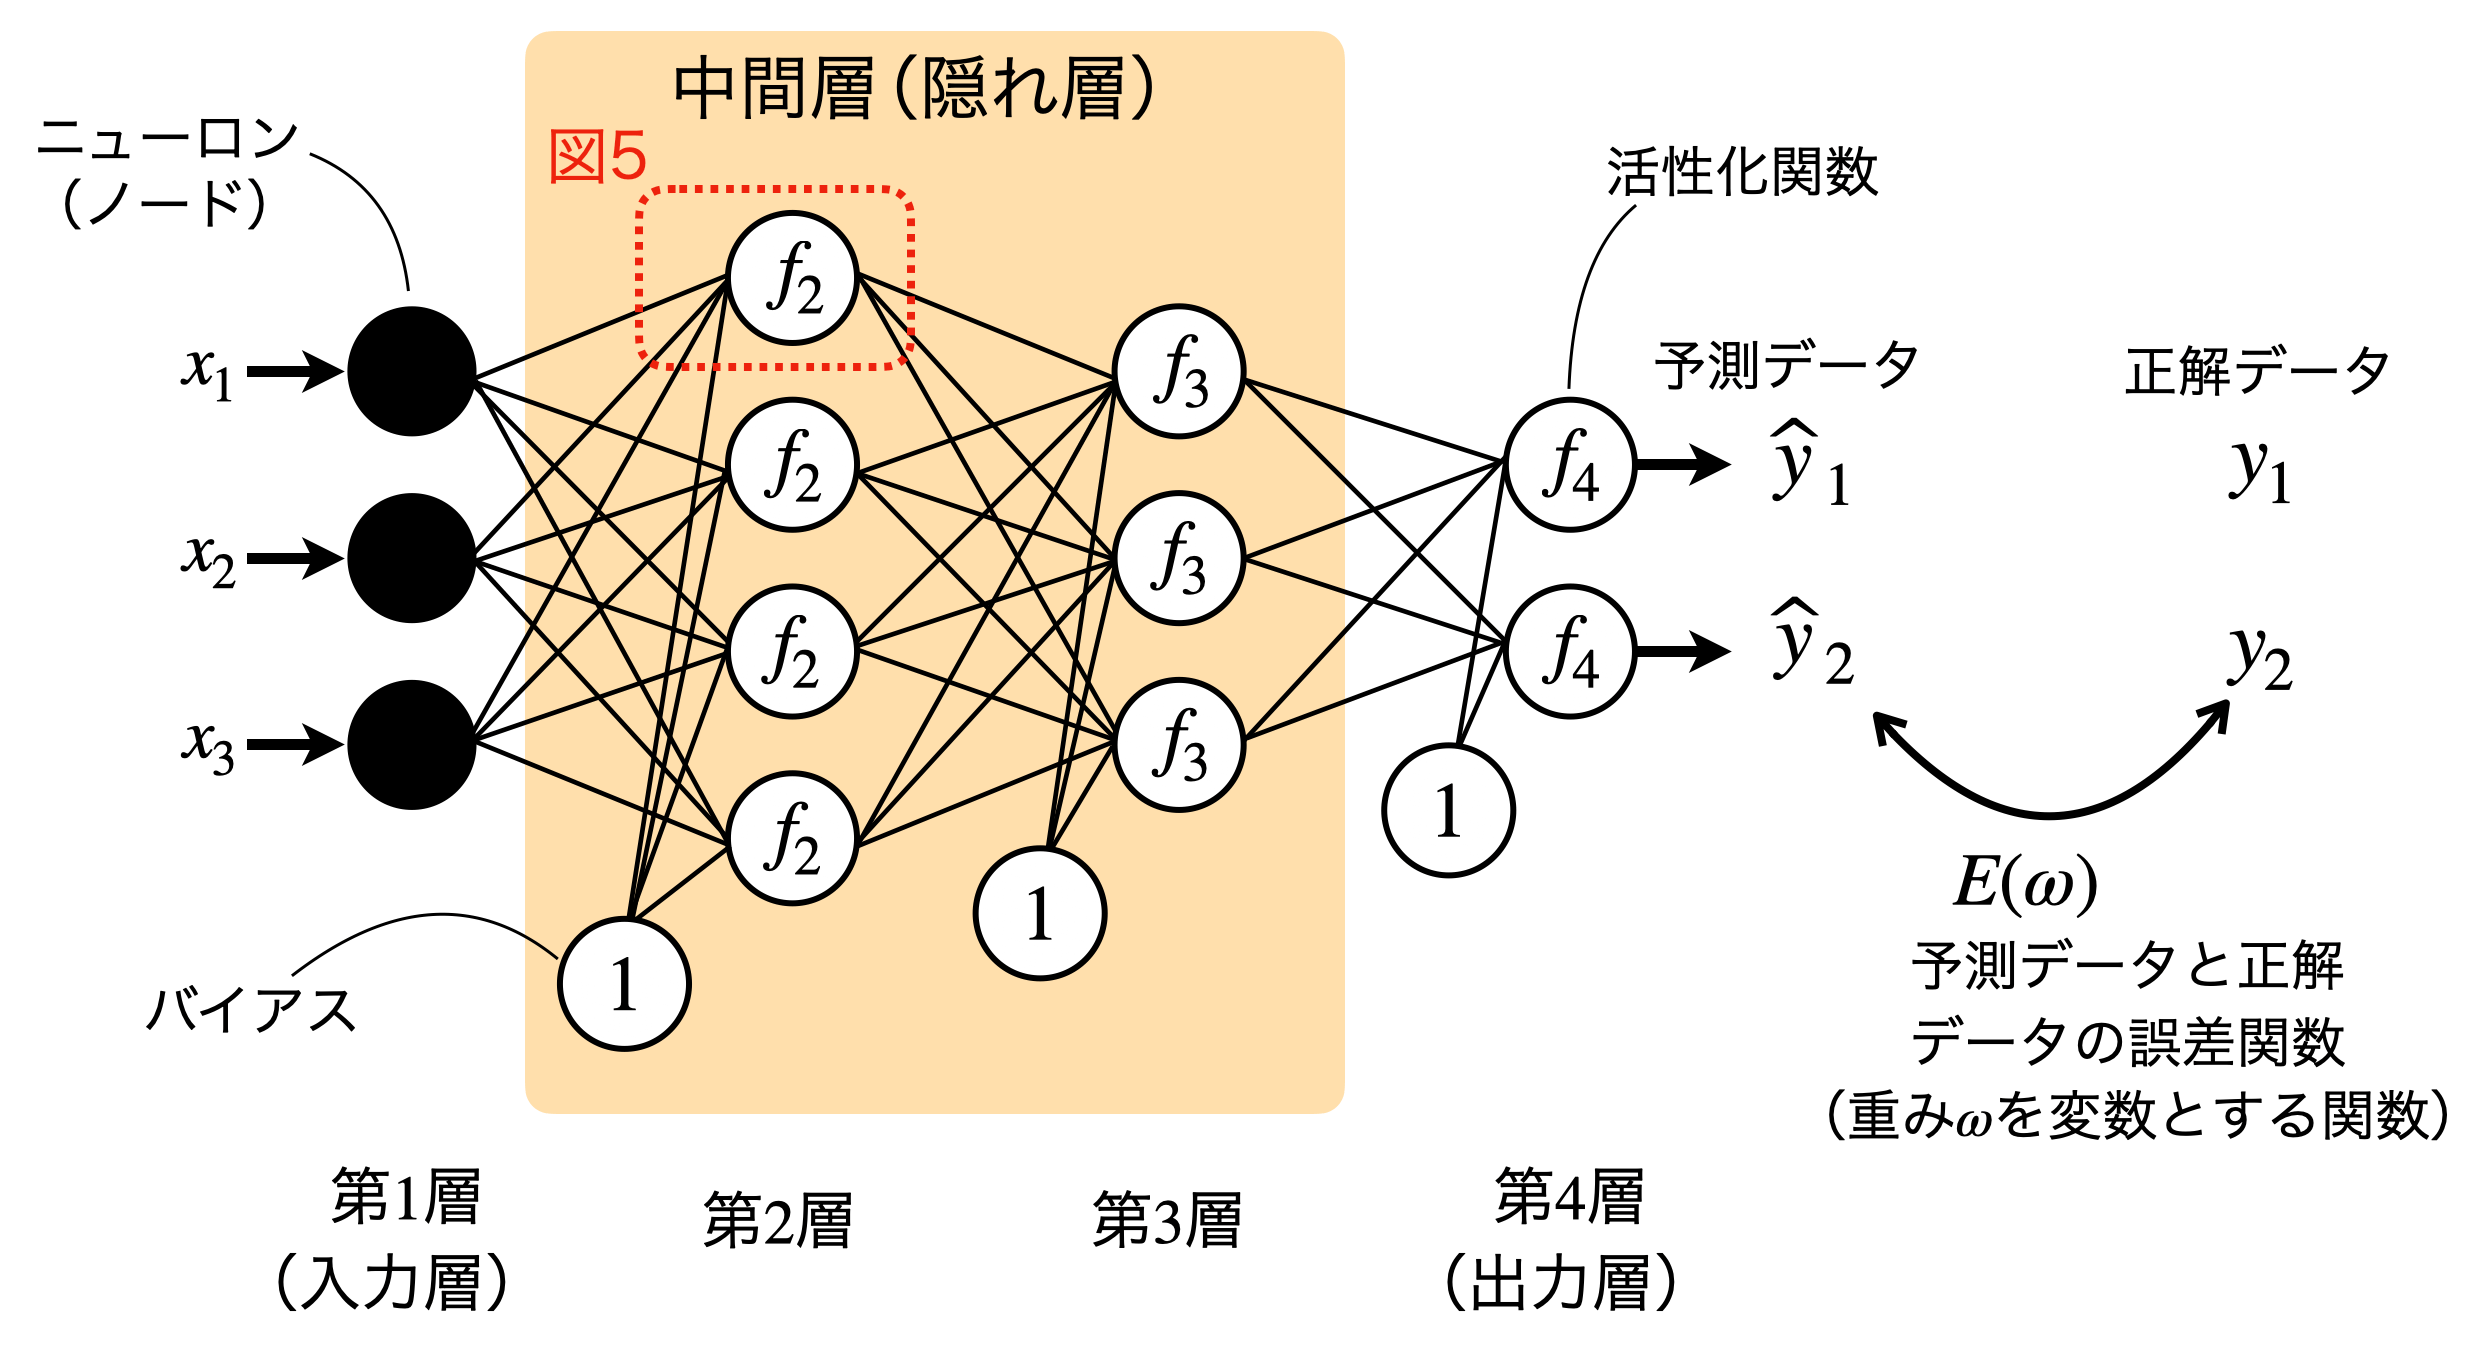
ディープラーニング 仕組みの土台となっているのは、人間の脳神経細胞の働きを工学的に再現した「ニューラルネットワーク」です。外部からの情報を受け取る「入力層」、情報の処理を行う「中間層(隠れ層)」、最終的な判定を下す「出力層」で構成されます。この中間層を何層にも深く(ディープに)重ねることから「深層学習」と命名されました。
学習のプロセスでは、各ノード(神経細胞に相当)同士のつながりの強さを示す「重み」と「バイアス」を微調整していきます。予測結果と実際の正解データのズレ(誤差)を算出し、そのズレを中間層へと逆方向に伝播させて数値を補正する「誤差逆伝播法(バックプロパゲーション)」と呼ばれるアルゴリズムが、驚異的な学習効率を支えています。
一口に深層学習といっても、扱うデータ種別によって適用される深層学習 アルゴリズム 種類は明確に分化しています。
- CNN(畳み込みニューラルネットワーク):画像の空間的な配置やテクスチャを捉えることに長けており、深層学習 画像認識の基礎として医療診断や顔認証システムを牽引しています。
- RNN(再帰型ニューラルネットワーク)およびLSTM:時系列データや文脈の前後関係を保持する設計で、音声認識や翻訳の初期基盤を築きました。
- Transformer(トランスフォーマー):データ内の各要素が互いにどう関係しているかを並列計算で測る「自己注意機構(Self-Attention)」を備え、深層学習 自然言語処理の勢力図を一変させました。現代の大規模言語モデル(LLM)の核心技術です。
【比較データ検証】従来型機械学習と深層学習の決定的な性能差・コスト構造
現場への導入判断において、深層学習が常に絶対的な正解というわけではありません。膨大な計算コストとデータ量を要するため、解決したい課題の規模や性質に応じた適切な見極めが求められます。下表は、開発現場のエンジニアへのヒアリングおよび大手IT調査レポートの数値データを統合した比較です。
| 項目 | 従来型機械学習(ML) | 深層学習(ディープラーニング) | 編集部の見解・評価 |
|---|---|---|---|
| 必要データ量 | 数百〜数千件の整形データで機能 | 数万〜数百万件以上の非構造化データ | データ収集基盤が貧弱な企業は従来型が無難 |
| 計算リソース・費用 | 一般的なCPU環境で高速学習可能 | 高性能GPU/TPUクラスタが必須(月数十万円〜) | インフラ投資回収の事業計画が不可欠 |
| 判断理由の透明性 | 高い(どの数値が効いたか可視化可能) | 極めて低い(ブラックボックス問題) | 金融与信や人命に関わる領域では規制の対象に |
| 性能の上限(天井) | データ量を増やしても早期に頭打ち | データとパラメータ量に応じて継続的に向上 | スケールメリットが効く領域では圧倒的勝者 |
【実態検証】現場データが暴く深層学習の活用事例と2026年最新動向
研究室を出た技術が社会のインフラとしてどのように溶け込んでいるのか、取材現場で見えてきた深層学習 活用事例は多岐にわたります。
製造業の現場では、外観検査装置にCNNを組み込むことで、熟練工が目視で行っていた微細なキズ判定の自動化が進んでいます。主要自動車部品メーカーの導入事例によると、検出精度は99.4%を記録し、検査工数を従来の約70%削減することに成功しました。また、医療領域ではCTやMRIの読影支援AIが普及し、早期肺がんの微小結節の見落とし防止において医師をサポートする標準装備となりつつあります。
そして深層学習 2026年最新動向として特筆すべきは、「モデルの大規模化競争」から「フィジカルAI(Physical AI)」および「エッジAIの高度化」へのシフトです。クラウド上の超巨大モデルを呼び出すだけでなく、ドローン、産業用ロボット、スマートグラスといった端末側の小さなチップ上で、量子化・蒸留された軽量モデルをミリ秒単位の超低遅延で動かす技術が急速に実用段階へ到達しています。デジタル空間のテキスト処理から、物理世界を動かすリアルタイム制御へと深層学習の主戦場は移り変わっています。
一般に知られていない盲点とネットの誤解|メリット・デメリットの真実
「深層学習さえ導入すれば、あらゆる業務課題が魔法のように解決する」という過度な期待は、開発現場を疲弊させる最大の要因です。メリットの裏に潜む深層学習 メリット デメリットのリアルを直視しなければなりません。
最大のメリットは、人間の認知限界を超える複雑な非線形パターンの発見力です。数億次元に及ぶ多変量データから潜在的な相関関係を割り出す力は、従来の統計手法では到底太刀打ちできません。しかしその反面、致命的なデメリットとして横たわるのが「判断根拠のブラックボックス性」です。数千万から数千億個のパラメータが複雑に絡み合っているため、「なぜその結論に至ったのか」を数学的に一意に説明することが極めて困難です。
この特性は、社会心理学における「オートメーション・バイアス(機械の提示した答えを無批判に信じ込んでしまう心理傾向)」と結びついたとき、重大な事故や倫理問題を引き起こします。融資審査の否決理由を顧客に論理的に説明できないリスクや、採用判定における学習データの潜在的差別の温存など、技術的完成度とは別のガバナンス上の課題が現場では深刻視されています。
【プロの結論】ディープラーニングを学ぶべき人・避けるべき人の判断基準と最短勉強法
テクノロジーが急速に成熟する環境下で、この技術とどう向き合うべきか。エンジニアとしてのスキル獲得やビジネス現場での導入を検討するにあたり、明確な適性判断基準が存在します。
向き不向きを見極める判断基準
- 積極的に深層学習へ進むべき人:画像・音声・テキストなどの非構造化データを扱い、既存のルールベースでは解決できない非線形な課題に直面している開発者。または、モデルのファインチューニングやエッジデバイス最適化など、実装レイヤーで技術的差別化を図りたいエンジニア。
- 慎重になるべき・従来手法を選ぶべき人:Excelで管理できるような数千行程度の表形式データ(構造化データ)の分析を主目的にしている人。また、法規制や業務要件により「判断プロセスの完全な説明責任」が法的に義務付けられている分野を扱う担当者(LightGBMやロジスティック回帰のほうが圧倒的に費用対効果と安全性が高くなります)。
挫折を防ぐディープラーニング勉強方法(初心者向け最短ロードマップ)
ディープラーニング 勉強方法 初心者が最も陥りやすい罠は、初手から大学レベルの線形代数や微分積分の教科書を丸暗記しようとして挫折するパターンです。現場のリードエンジニアが口を揃えるのは「動くコードから入り、必要に応じて理論へ遡る」アプローチの重要性です。
まずはディープラーニング Python 実装のデファクトスタンダードである「PyTorch」を用い、Google Colaboratoryなどのクラウド環境で既存のオープンソースモデルを動かしてみることから始めるのが堅実です。入力画像がどのようなテンソル(数値配列)として処理され、出力値へ変換されるのかを体感した上で、損失関数や最適化アルゴリズムの数式を学ぶことで、知識が点から線へとつながります。
【深層学習とは】に関するよくある質問(FAQ)
Q1:初心者が深層学習を学ぶには、高度な数学の知識が必須ですか?
A1:ライブラリを使ってモデルを動かしたり、既存モデルを自社データに適応させる程度であれば、高度な数式計算を手作業で行う必要はありません。四則演算と行列の概念、傾きを求める微分の大枠さえ理解していれば、Pythonのフレームワーク(PyTorchなど)が複雑な計算を自動処理してくれます。ただし、モデルの構造を一から設計したり、論文を正確に読み解く研究開発レベルを目指す段階では、線形代数、多変数微積分、確率統計の深い理解が不可欠です。
Q2:中小企業の業務効率化に、自前の深層学習モデル構築は必要ですか?
A2:多くの場合、スクラッチでの自社モデル開発はコストパフォーマンスに見合いません。2026年現在は、大手プラットフォーマーが提供する高精度の事前学習済みモデルやAPIをクラウド経由で活用する、あるいは既存モデルを小規模なデータで微調整(ファインチューニング)する手法が主流です。独自開発を行うべきなのは、他社が決して持っていない独自の特殊データが存在し、それが事業の競争優位性に直結する場合に限られます。
Q3:ディープラーニングの「ブラックボックス問題」は解決されつつあるのですか?
A3:完全に透明化されたわけではありませんが、「説明可能AI(XAI: Explainable AI)」の研究が大きく前進しています。画像のどの部分を注視して判断したかを熱分布で可視化する「Grad-CAM」や、判定に影響を与えた特徴量を算出する「SHAP」などの技術が実務に導入され、医療診断支援や自動運転の検証ログ解析など、安全性が最優先される領域で実用化が進んでいます。
まとめ:今後の動向と失敗しないための判断基準
深層学習(ディープラーニング)は、人間が手作業で行っていた特徴の抽出を自動化し、データの中に眠る複雑な構造をあぶり出すことで、現代の知能化社会を切り拓いてきました。画像認識や自然言語処理の飛躍的な発展は、まさにこの技術的跳躍によってもたらされた果実です。
しかし、技術の進化が加速するからこそ、その万能性を盲信するのではなく、「大量のデータと莫大な計算リソースを要する」「判断過程が複雑化する」という構造的特質を冷静に把握することが求められます。課題の性質を正しく見定め、シンプルな統計手法で足りるのか、それとも深層学習のパワーを投入すべきなのかを峻別できるリテラシーこそが、技術の波に呑まれず確かな価値を生み出すための分岐点となります。 (出典: 深層 学習 と は(Yahoo!ニュース))
テクノロジーやライフスタイル領域を中心に執筆活動を行っています。趣味は写真撮影と旅行です。
